你让四个AI团队写同一份竞品调研报告,结果收到四份‘都对、但都不一样’的答案——有的列了六条结论带链接,有的直接帮你抄作业步骤,还有的把账号起号时间写错了三天。不是模型瞎编,也不是工具失灵,是它们背后的Harness根本没对齐:一个用搜索工具捞最新数据,一个靠缓存旧文档归纳,第三个压根没触发检索,第四个调了OCR但传错了图片分辨率。
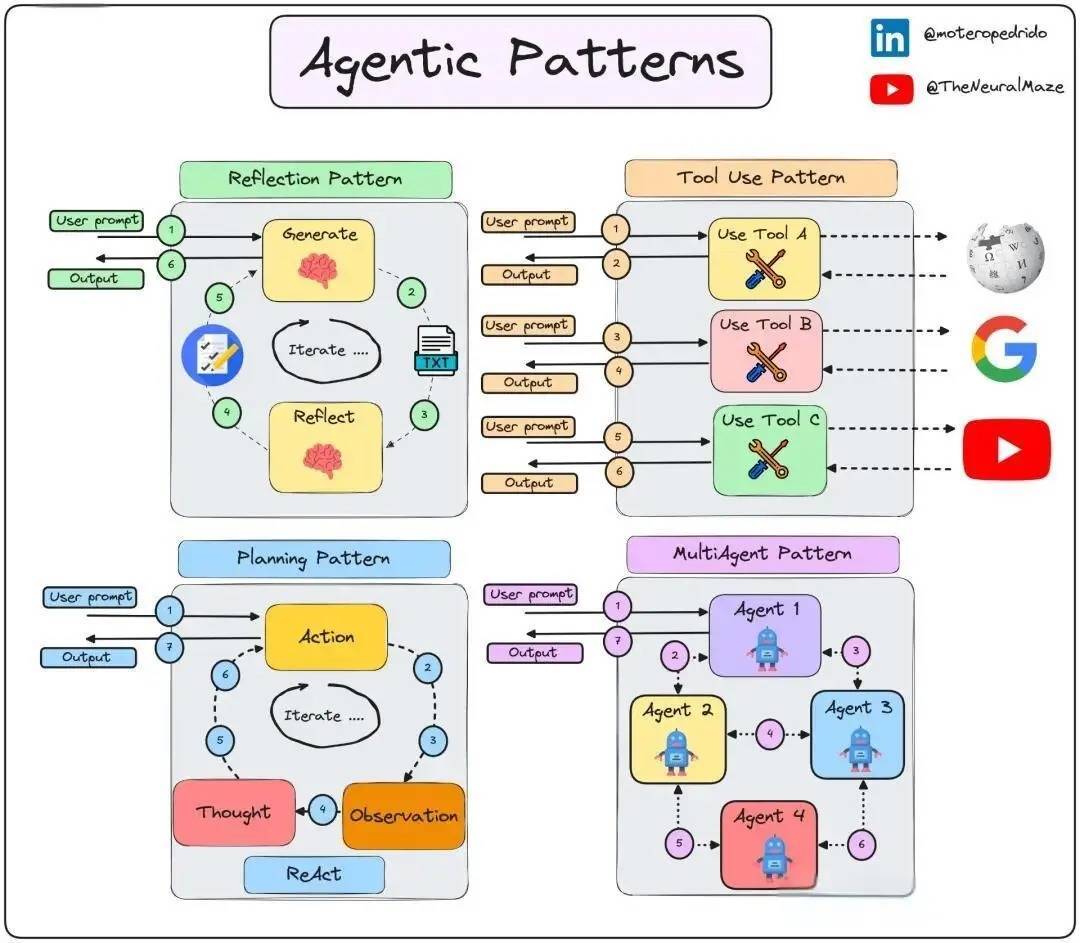
这哪是AI在答题?分明是四个不同工种的同事在开线上会议:销售在讲用户情绪,技术在查日志报错,法务在核条款细节,而老板在等一句‘能不能干’。没人说谎,但每人只听见自己那段上下文。LangChain早把话挑明了:Agent = Model + Harness。模型是脑子,Harness才是手脚+耳朵+记事本+刹车片。可现实里,我们总在给脑子换CPU,却让手脚穿拖鞋跑马拉松。
更扎心的是,WHALE论文用实验证实:模型和Harness必须交替进化。固定Harness猛训模型?模型学会的‘套路’可能被旧代码锁死;光改Prompt不碰底层工具链?再聪明的AI也像戴着泳镜下围棋——看得见棋盘,摸不着气口。可企业真按这个节奏滚起来?每周微调模型、重搜Harness、更新环境接口、重跑全链路评测……运维团队怕是要连夜改简历。所以现在一线团队的真实解法很务实:确定性任务走老架构(比如客服问答),用多Agent分段兜底;探索性任务切新引擎(比如诊断分析),让单Agent挂Skill自主编排。信谁?不选模型,也不信Harness,信的是‘哪段流程需要人盯住哪段接口’。
这其实不是技术问题,而是分工哲学的落地难题。就像医院里CT机再先进,也得有放射科医生判图、临床医生结合症状解读、护士跟进患者反馈——每个环节都不可替代,但谁该在什么节点介入、留多少决策余地,得靠真实业务流倒推,不是靠PPT画个Agent架构图就完事。
我们跟深圳一家做跨境财税SaaS的团队聊过,他们把“海外税务政策变动提醒”这个需求拆成了三段:第一段用固定Harness+轻量模型扫各国官网PDF公告(准确率92%,错的多是语言歧义);第二段触发人工标注队列,由本地税务顾问确认是否真影响客户;第三段才让AI生成适配不同国家客户的提醒话术。整个链路里,模型只负责“找原文”,Harness管“下对文档、转对格式、传对字段”,而人卡在“判实质影响”这个无法被规则穷尽的环节。上线半年,误报率从37%压到4.8%,客户投诉反降了15%——因为提醒更准了,而且每条背后都有顾问签名和依据链接。
还有个反常识但很实在的发现:不少团队不是缺好模型,而是缺“能退回去”的能力。比如某教育公司曾用RAG+微调模型做教辅题解析,结果学生问“这道题为什么不能用洛必达法则”,AI一本正经编出三条数学史依据……后来他们在Harness里加了个“质疑缓冲层”:当检测到问题含“为什么不能”“有没有例外”“老师说错了”等否定/质疑类短语,自动切回规则引擎查知识图谱,再不行就弹出“请教研组复核”按钮。不是所有问题都要AI答完,有些问题的价值,恰恰在于它被按下了暂停键。
所以别再问“哪个模型更强”,该问“这段流程里,谁最怕出错?错一次成本多高?有没有兜底的物理开关?”——真正的智能,不在答案多漂亮,而在出错时,系统知道该把方向盘交到谁手里。
通弘网提示:文章来自网络,不代表本站观点。